Informacja jest już w systemie. Dlaczego nadal trzeba coś przepisywać?
Handlowiec kończy rozmowę z klientem i zapisuje w CRM-ie:
„Klient dostał od konkurencji lepszą cenę. Mam zadzwonić w przyszłym tygodniu i wrócić do tematu”.
Notatka jest. Historia kontaktu została uzupełniona. Tylko że ktoś nadal musi utworzyć zadanie, przypisać termin i zdecydować, czy sprawa wymaga dodatkowej uwagi.
Podobny problem można sobie wyobrazić w sklepie internetowym. Dostawca przekazuje plik z produktami. Są nazwy, opisy i część parametrów, ale ktoś musi przyporządkować towary do kategorii sklepu, wybrać tagi oraz uporządkować cechy.
W obu sytuacjach nie chodzi przede wszystkim o napisanie kolejnego tekstu. Chodzi o podjęcie wielu niewielkich decyzji na podstawie informacji, które już mamy.
Właśnie takim zadaniom warto przyjrzeć się przy okazji Jev — modelu AI firmy TypeSafe, zaprojektowanego do zwracania ustrukturyzowanych ocen i wyborów, które może wykorzystać aplikacja. Zamiast prowadzić rozmowę, pomaga określić, co powinno wydarzyć się dalej. [1]
Najciekawsze jest połączenie trzech właściwości: szybkiej odpowiedzi, bardzo niskiego kosztu i wyniku nadającego się do użycia w programie. To otwiera drogę nie tylko do analizy komentarzy, lecz również do zastępowania części rozbudowanych reguł interpretujących tekst. [2][3][6]
Czym jest Jev — bez wchodzenia w niepotrzebne szczegóły
Jev można potraktować jako funkcję decyzyjną wewnątrz aplikacji. Przekazujemy jej informacje oraz jasno określone pytanie.
Na przykład: „Do której z tych kategorii pasuje produkt?”, „Czy komentarz zawiera zobowiązanie do ponownego kontaktu?” albo „Jak pilnej obsługi wymaga zgłoszenie?”.
Wynik nie musi być opisowy. Dokumentacja wyróżnia trzy rodzaje pytań: Choice, czyli wybór jednej opcji; Score, czyli ocenę według opisanej skali; oraz Noul, czyli prawdopodobieństwo odpowiedzi „tak” na określone pytanie. Aplikacja może wykorzystać te wyniki do wyboru działania. [1]
Schemat jest prosty:
Informacja z firmy → ocena modelu → reguły aplikacji → konkretna czynność.
Jev nie loguje się sam do CRM-u ani nie klika kategorii produktu. To kod aplikacji wykonuje operację, kontroluje uprawnienia i pilnuje poprawnego zapisu. Model obsługuje ten fragment, w którym potrzebna jest interpretacja informacji. Takie połączenie zwykłego oprogramowania i wąsko zdefiniowanych ocen opisuje TypeSafe. [5]
Dla pracownika efekt może być bardzo naturalny: zapisuje komentarz i widzi dodane zadanie. Nie otwiera osobnego czatu i nie kopiuje danych między oknami.
Ułamki sekundy: AI jako część działania aplikacji
TypeSafe podaje dla Jev czas odpowiedzi 70–500 milisekund, czyli 0,07–0,5 sekundy. W dokumentacji projektowania aplikacji opisuje też wiele zapytań kończących się w około 100 ms. To deklaracje producenta, nie pomiar wykonany przez ProcesON; opublikowane testy były zazwyczaj prowadzone z zachodniego wybrzeża USA, gdzie znajdowała się usługa. [3][5]
Nie chodzi więc wyłącznie o tańszą analizę na koniec dnia. Krótka odpowiedź pozwala rozważać ocenę AI bezpośrednio w przepływie pracy aplikacji.
Wyobraźmy sobie zapis zgłoszenia. System może od razu rozpocząć rozpoznawanie jego tematu i wskazać właściwy dział. Po imporcie produktu może uruchomić wybór kategorii. Po dodaniu notatki handlowca — przygotowanie kolejnego zadania.
Skąd bierze się ta szybkość?
Model językowy generuje odpowiedź kolejno, fragment po fragmencie. Jev według opisu producenta rezygnuje z generowania swobodnego tekstu i zwraca wyniki pytań równolegle. Jest projektowany pod szybkie, uporządkowane decyzje, a nie pod pisanie wypowiedzi. [3]
Przy komentarzu możemy potrzebować kilku ustaleń: czy konieczny jest kontakt, czy chodzi o cenę, czy występuje reklamacja i czy sprawa wymaga dodatkowej uwagi. Nie trzeba pytać o nie w czterech kolejnych zapytaniach. TypeSafe pozwala ocenić kilka niezależnych pytań w jednym wywołaniu; według dokumentacji dodanie pytań zwykle niewiele zmienia czas odpowiedzi. [4]
To różnica między czekaniem na kolejne kroki analizy a otrzymaniem zestawu ocen, z których aplikacja od razu wybiera potrzebne informacje.
Pełny czas działania funkcji obejmuje jeszcze sieć, bazę danych i ewentualne API sklepu. Nie podaję mnożnika szybkości względem GPT-6 Luna, ponieważ nie wykonaliśmy bezpośredniego pomiaru obu modeli na tym samym zadaniu. Podane ułamki sekundy opisują deklarowany czas odpowiedzi Jev, a nie gwarantowany czas wykonania całego procesu.
Czy model decyzyjny może zastąpić część algorytmów?
Tak — przede wszystkim część ręcznie pisanych reguł służących do interpretowania nieuporządkowanych informacji. Takie zastosowanie opisuje TypeSafe jako włączanie ocen modelu w zwykły kod programu. [5]
Załóżmy, że tworzymy automatyczne zadania z komentarzy. Pierwszy pomysł może brzmieć:
Jeżeli w notatce występuje słowo „zadzwonić”, utwórz zadanie telefoniczne.
Tylko co zrobić z takimi zapisami?
| Przykładowy komentarz | Sens, który powinna rozpoznać aplikacja |
|---|---|
| „Zadzwonić w przyszłym tygodniu”. | Zaplanować kontakt. |
| „Nie trzeba już dzwonić, sprawa zamknięta”. | Nie tworzyć nowego zadania kontaktowego. |
| „Obiecałem, że wrócę do niego po weekendzie”. | Rozpoznać zobowiązanie do kontaktu mimo innego słownictwa. |
| „Klient sam zadzwoni, kiedy skończy mu się towar”. | Nie traktować tego automatycznie jako zobowiązania handlowca. |
To przykłady oczekiwanej interpretacji, nie wyniki testu modelu.
Przy podejściu opartym tylko na słowach kluczowych trzeba dopisywać odmiany wyrazów, negacje i kolejne wyjątki. W języku technicznym pojawiają się parsery oraz wyrażenia regularne — mechanizmy wyszukujące określone wzorce w tekście.
Model decyzyjny pozwala inaczej zdefiniować problem: zamiast sprawdzać, czy wystąpiło konkretne słowo, pytamy, czy treść rzeczywiście zawiera zobowiązanie do następnego kontaktu.
Projektowo oznacza to możliwość zastąpienia części słowników i wyjątków jedną funkcją oceniającą sens. Nadal trzeba precyzyjnie opisać kryteria, sprawdzić błędne przypadki i określić dopuszczalne działania. Dokumentacja Jev podkreśla znaczenie jednoznacznych instrukcji i testowania sytuacji granicznych. [9]
Nie każdy algorytm warto zastępować AI
Obliczenie wartości zamówienia, sprawdzenie uprawnień czy porównanie dat powinno pozostać w zwykłym kodzie. Model nie jest potrzebny do ustalenia, czy termin płatności już minął. TypeSafe również zaleca pozostawienie arytmetyki i porównań dat poza Jev. [9]
Dobry podział wygląda tak: kod odpowiada za rzeczy jednoznaczne, model za interpretację, a aplikacja łączy wyniki i wykonuje działanie.
Podobnie w logistyce: algorytm może obliczać trasę, a model pomagać ocenić, czy uwaga do zamówienia opisuje nietypowy warunek dostawy wymagający uwagi dyspozytora. To propozycja zastosowania, nie zastąpienie matematycznej optymalizacji tras przez Jev.
Ile kosztuje zapytanie do Jev?
W cenniku Jev 1.13, sprawdzonym 27 września 2026 r., cena wynosi 0,042 USD za milion tokenów wejściowych, bez osobnej opłaty za wyjście. Token to jednostka rozliczeniowa przetwarzanego tekstu; dla firmy ważniejsze jest jednak to, ile kosztuje obsługa komentarzy czy produktów. [6]
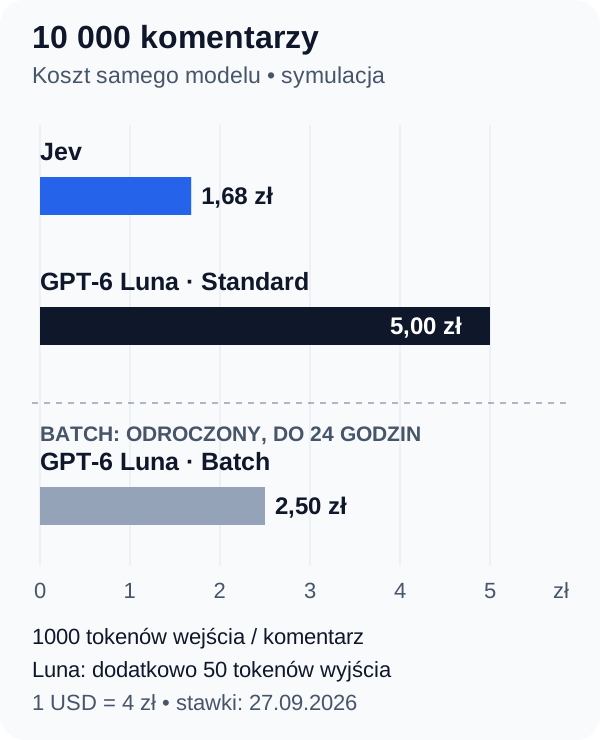
Analiza 10 000 komentarzy za 1,68 zł
Przyjmijmy, że całe pojedyncze wywołanie — komentarz, pytania i potrzebny kontekst — ma 1000 tokenów wejściowych. Dla GPT-6 Luna przyjmujemy dodatkowo krótką odpowiedź długości 50 tokenów. To założenie do symulacji, nie zmierzona długość cytowanej notatki. Umowny kurs wynosi 1 USD = 4 zł.
| Liczba przeanalizowanych komentarzy | Jev 1.13 | GPT-6 Luna — Standard |
|---|---|---|
| 1000 | około 0,17 zł | 0,50 zł |
| 10 000 | 1,68 zł | 5,00 zł |
| 100 000 | 16,80 zł | 50,00 zł |
| 1 000 000 | 168,00 zł | 500,00 zł |
Obliczenia własne według oficjalnych stawek Jev i GPT-6 Luna. Koszt samego modelu, nie całej aplikacji. Szczegóły rozliczenia znajdują się na końcu artykułu. [6][7]
W tej symulacji Jev jest około trzykrotnie tańszy od Luny Standard. Jedna ocena kosztuje około 0,017 grosza.
Przy 3000 komentarzy miesięcznie daje to około 50 groszy za same oceny Jev. Przy 1000 komentarzy dziennie przez 22 dni robocze — około 3,70 zł.
To istotne nie tylko przy ogromnej skali. Można rozważyć analizę każdej nowej notatki, zamiast ograniczać funkcję do kilku spraw dziennie. Jeżeli aplikacja ma wykonywać tysiące niewielkich ocen, niski koszt przestaje być przeszkodą przy projektowaniu takiego procesu.
Dlaczego porównujemy z lekkim LLM-em?
GPT-6 Luna jest oferowany przez OpenAI do skoncentrowanych zadań o dużej skali i obsługuje uporządkowane odpowiedzi. Porównujemy więc z lekkim modelem, a nie z najdroższą usługą nastawioną na rozbudowane analizy. [7]
Zaletą Jev nie jest tylko niższa kwota w tabeli. To połączenie kosztu z szybkim, wyspecjalizowanym interfejsem decyzyjnym. LLM może tworzyć opis produktu; Jev można wykorzystać w węższej roli, na przykład do wyboru kategorii i oceny zgodności opisu z tagiem. [2]
Dla pełności wyliczenia: Luna Batch kosztowałaby w tym scenariuszu 2,50 zł za 10 000 analiz. Jest to tryb zbiorczy z 24-godzinnym oknem realizacji, nie odpowiednik interaktywnej reakcji po kliknięciu. Inne tryby i cache mogą zmieniać porównanie; nie są uwzględnione w głównej tabeli. [7][8]
Automatyczne tworzenie zadań dla handlowców i pracowników w CRM
Rozwijając dla klienta aplikację CRM wspierającą pracę handlowców, analizuję właśnie taki kierunek rozbudowy: komentarz nie tylko zapisuje historię, lecz również uruchamia następny krok.
Poniższy przykład opisuje koncepcję funkcji, a nie wyniki zakończonego wdrożenia Jev.
Wróćmy do notatki:
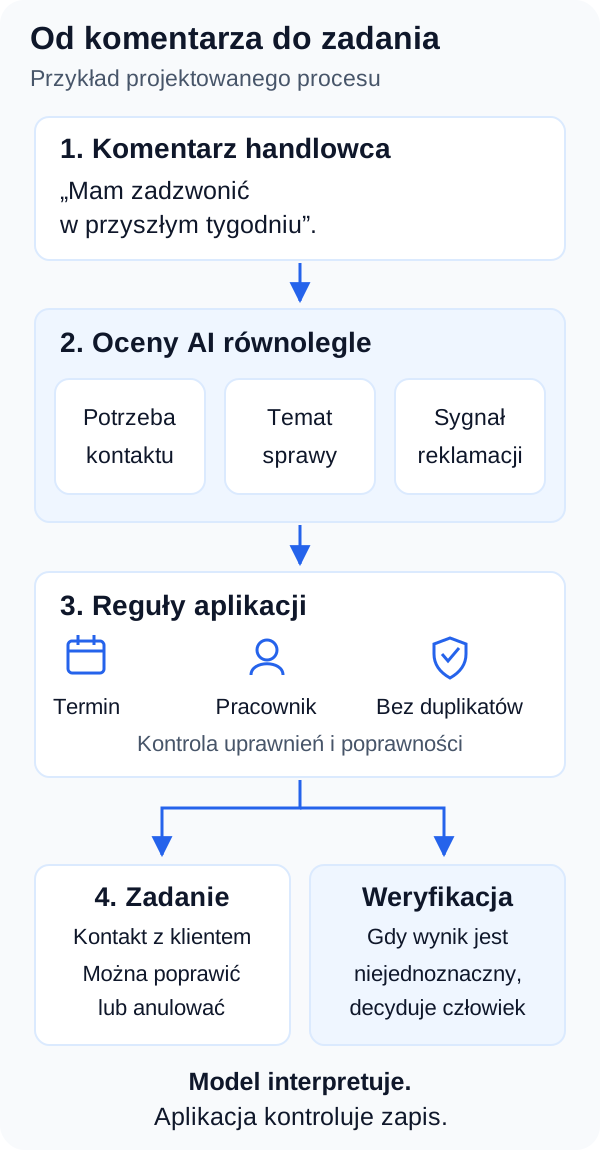
„Klient dostał od konkurencji lepszą cenę. Mam zadzwonić w przyszłym tygodniu i wrócić do tematu”.
Nie potrzebujemy obszernej analizy relacji. Potrzebujemy rozpoznać zobowiązanie do kontaktu, temat sprawy i ewentualny sygnał wymagający uwagi.
Ten sam komentarz, dwa sposoby uzyskania wyniku
| Element | LLM, np. GPT-6 Luna | Jev |
|---|---|---|
| Sposób odpowiedzi | Krótki, wygenerowany wynik w ustalonej strukturze. | Wyniki zdefiniowanych pytań: wybory i oceny. |
| Przykładowe oczekiwane ustalenia | Potrzebny kontakt; forma: telefon; temat: warunki cenowe. | Potrzebny kontakt; forma: telefon; temat: warunki cenowe. |
| Co robi aplikacja? | Odbiera wynik, sprawdza reguły i tworzy zadanie. | Odbiera wynik, sprawdza reguły i tworzy zadanie. |
| Koszt 10 000 analiz w opisanej symulacji | 5,00 zł w Standard. | 1,68 zł. |
To ilustracja projektowanego działania, nie zapis odpowiedzi otrzymanych z modeli. Nie dowodzi identycznej skuteczności obu rozwiązań. Możliwości interfejsów opisują producenci. [1][7]
Docelowy przebieg funkcji mógłby wyglądać tak:
Handlowiec zapisuje komentarz przy konkretnym kliencie.
Aplikacja przekazuje jego treść i potrzebny kontekst do oceny.
Model rozpoznaje zapowiedź kontaktu oraz temat rozmowy.
Aplikacja sprawdza istniejące zadania, przypisuje pracownika i stosuje reguły terminu.
Handlowiec widzi dodane zadanie połączone z komentarzem; może je poprawić lub anulować.
Tytuł nie musi być za każdym razem tworzony przez LLM. Można użyć szablonu: „Kontakt z klientem — omówienie warunków cenowych”. Do opisu dołączymy oryginalną notatkę.
Z terminem trzeba postąpić ostrożniej. „W przyszłym tygodniu” nie oznacza konkretnego dnia ani godziny. Aplikacja może zastosować uzgodniony z firmą dzień kontaktu albo poprosić o doprecyzowanie. Ustalenie wynikające z reguły systemowej nie powinno udawać terminu podanego przez klienta.
W niektórych przypadkach wystarczy parser dat, w innych pomocniczy model językowy. Jev może odpowiadać za rozpoznanie potrzeby działania, a kod za ustalenia kalendarzowe. To podział zgodny z dokumentowanymi ograniczeniami modelu. [9]
Sama wzmianka o lepszej cenie konkurencji nie powinna automatycznie oznaczać „klient odchodzi”. Może być sygnałem do analizy, ale poważniejsza ocena wymaga szerszego kontekstu.
Projektując tę funkcję, zadbałbym także o ochronę przed duplikatami oraz zapis komentarza niezależny od dostępności AI. Notatka zostaje zachowana, a nieudana analiza może zostać ponowiona bez tworzenia kilku zadań do tej samej sprawy.
Szerszy kontekst organizacji tej pracy opisuję w artykule o CRM-ie dla hurtowni budowlanej.
PrestaShop: automatyczne kategorie, tagi i cechy produktów
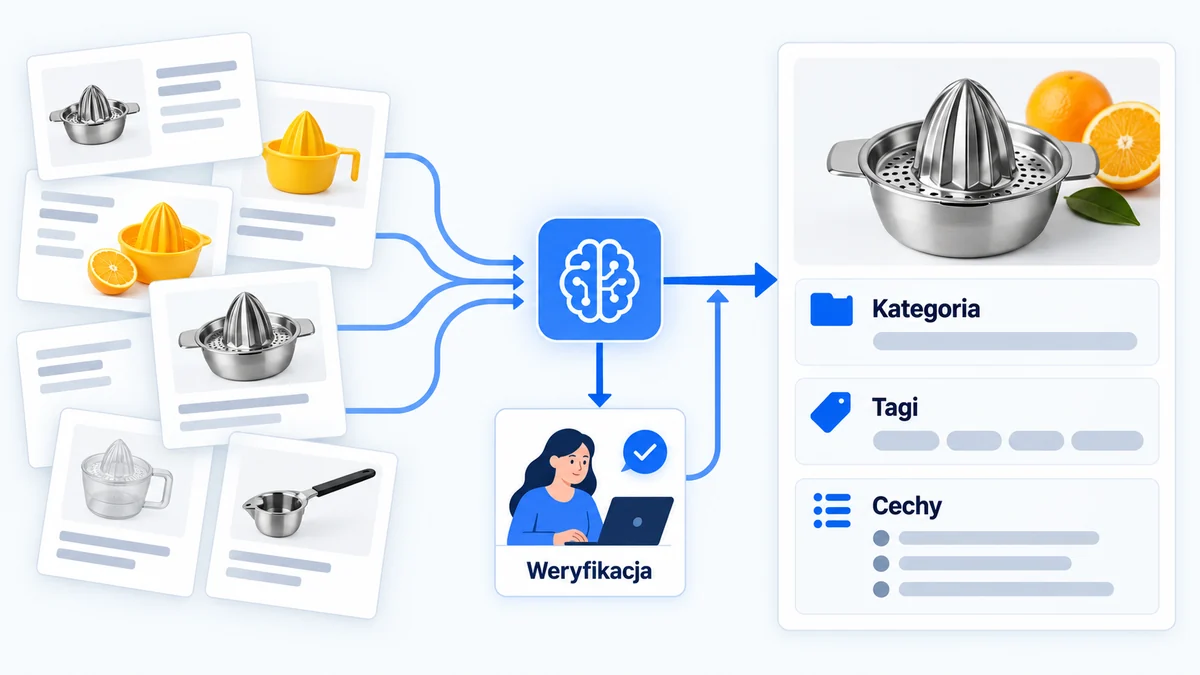
Drugim zastosowaniem jest porządkowanie katalogu sklepu internetowego. Nie chodzi tylko o tworzenie opisów. Istotne jest dopasowanie danych dostawcy do tego, jak sklep organizuje asortyment.
Załóżmy, że przychodzi opis:
„Ręczny wyciskacz do cytrusów ze stali nierdzewnej. Mycie ręczne”.
Sklep ma już własne kategorie i słownik parametrów. Dla tego przykładu oczekiwane przypisanie mogłoby wyglądać tak:
| Element | Rola w projektowanym procesie | Przykładowy wynik |
|---|---|---|
| Kategoria | Umieszczenie w strukturze katalogu. | Kuchnia → Akcesoria → Wyciskacze ręczne. |
| Tagi | Dodatkowe oznaczenia ze słownika sklepu. | Cytrusy; ręczne wyciskanie. |
| Cechy produktu | Uporządkowane parametry opisowe. | Materiał: stal nierdzewna; sposób mycia: ręczne. |
To ilustracja oczekiwanego działania. PrestaShop dokumentuje osobne powiązania produktu z kategoriami, tagami i cechami. [11]
Jak działałoby automatyczne tagowanie produktów PrestaShop?
Przy imporcie aplikacja pobiera opis produktu i dozwolone oznaczenia sklepu. Model nie musi wymyślać nowych tagów. Może oceniać, które z istniejących pasują do danych produktu.
W ten sposób „stal nierdzewna”, „wykonanie nierdzewne” i jednoznaczny odpowiednik w danych innego dostawcy mogą prowadzić do tego samego oznaczenia. Celem jest ujednolicenie informacji, a nie powiększanie listy podobnych nazw.
W Jev pytanie Choice wybiera jedną opcję ze zdefiniowanego zestawu. Dla kilku tagów można oceniać osobno zgodność produktu z poszczególnymi oznaczeniami i połączyć wyniki w aplikacji. [10][1]
Przy rozbudowanym katalogu zaprojektowałbym najpierw zawężenie listy sensownych kategorii, a potem dokładne dopasowanie. Całe drzewo sklepu nie musi trafiać do każdego zapytania. Dodatkowe etapy i długość opisów kategorii trzeba jednak uwzględnić w kosztach.
Przypisywanie cech to coś więcej niż dobór tagów
Dla cechy „materiał” model może pomóc dopasować opis do istniejącej wartości „stal nierdzewna”. Aplikacja korzysta potem z identyfikatora tej wartości w sklepie, zamiast zapisywać kolejne warianty tej samej nazwy.
Oficjalna dokumentacja PrestaShop pokazuje tworzenie cech, ich wartości i przypisywanie ich produktom przez Webservice API. API jest tu sposobem komunikacji między aplikacją a sklepem, bez ręcznego klikania każdego produktu w panelu. [12]
Trzeba odróżnić cechy opisowe od atrybutów używanych do tworzenia wariantów sprzedażowych. Informacja „materiał: stal nierdzewna” to inna operacja niż utworzenie kombinacji produktu z własną ceną i stanem. PrestaShop dokumentuje te mechanizmy osobno. [12][13]
Od pliku dostawcy do zapisu w sklepie
Projektowany przepływ mógłby obejmować pobranie nowych lub zmienionych produktów, przygotowanie zestawu dopuszczalnych kategorii i oznaczeń, ocenę przez Jev, a następnie kontrolę wyników i zapis przez API.
Model ocenia dopasowanie. Aplikacja sprawdza, czy wskazana kategoria i wartość cechy istnieją, czy produkt nie ma już odpowiednich oznaczeń i czy zmiana może zostać wykonana automatycznie. Możliwość zapisu opiera się na powiązaniach udostępnionych w Webservice PrestaShop; szczegóły trzeba dopasować do wersji i konfiguracji sklepu. [11][12]
Przed masową aktualizacją przygotowałbym podgląd proponowanych zmian. Po testach można włączyć automatyczne zapisy dla dobrze działających przypadków, a pozostałe kierować do sprawdzenia.
Ile kosztuje przetworzenie 50 000 produktów?
Przy założeniu 2000 tokenów wejściowych na produkt, jednego wywołania i 100 tokenów odpowiedzi Luny otrzymujemy:
| Wariant | Koszt samej analizy 50 000 produktów |
|---|---|
| Jev | 16,80 zł |
| GPT-6 Luna — Standard | 50,00 zł |
| GPT-6 Luna — Batch | 25,00 zł |
Symulacja według stawek producentów, przy umownym kursie 1 USD = 4 zł; nie obejmuje integracji i utrzymania. [6][7][8]
To pokazuje potencjał masowego przetwarzania: koszt samych ocen może pozostać niewielki nawet przy dużym katalogu. Nie jest to jednak gwarancja uporządkowania dowolnych 50 000 produktów za tę kwotę. Znaczenie mają ilość danych, liczba etapów i konieczne powtórzenia.
Po pierwszym uporządkowaniu katalogu przetwarzałbym tylko nowe i istotnie zmienione pozycje. Oszczędność daje nie tylko tani model, lecz także unikanie zbędnej pracy.
Przy większej skali potrzebna jest kolejka uwzględniająca limity usługi. Krótki czas pojedynczej odpowiedzi nie oznacza nieograniczonej liczby równoległych wywołań. TypeSafe publikuje limity i zaznacza, że mogą się zmieniać. [6]
Brak informacji nie powinien zamieniać się w zgadnięty parametr
Jeżeli opis nie podaje materiału, certyfikatu albo warunków użytkowania, aplikacja powinna dopuszczać wynik „brak danych” lub „do weryfikacji”. Nie projektowałbym jej tak, aby uzupełniała brakujące parametry przez zgadywanie.
Opisywana wersja Jev obsługuje tekst, nie zdjęcia. Odczyt informacji z fotografii wymaga osobnego etapu i może zmienić koszt całego procesu. [6]
A co, gdy AI podejmie złą decyzję?
Poprawna struktura odpowiedzi nie gwarantuje właściwej interpretacji. Wybrana kategoria może istnieć, a mimo to nie pasować do produktu. TypeSafe zaznacza, że kalibracja ocen nie zapewnia poprawności pojedynczej odpowiedzi. [2]
Jev zwraca informacje o niepewności. Przy wyborach i ocenach dostępny jest również wskaźnik confidence. Nie traktowałbym jednak liczby 0,95 jako automatycznej gwarancji 95-procentowej skuteczności na danych danego sklepu. Znaczenie wskaźników i progi działania trzeba sprawdzić na własnych przypadkach. [14]
W aplikacji można rozdzielić sprawy obsługiwane automatycznie, wymagające zatwierdzenia oraz takie, przy których system nie powinien nic zmieniać. Takie sterowanie działaniem na podstawie pewności opisuje dokumentacja TypeSafe. [15]
Nie stosowałbym tych samych zasad do dodania odwracalnego tagu i do wysłania wiadomości klientowi. Waga działania powinna wpływać na wymagania dotyczące kontroli.
Przetestowałbym również rzeczywiste polskie komentarze: skróty, literówki, branżowe określenia i zdania z negacją. TypeSafe wskazuje, że najlepszą jakość uzyskuje obecnie dla języka angielskiego, i zaleca osobne testy pozostałych języków. [6]
Nie trzeba wymieniać całego systemu, żeby wykorzystać taki model
W tych scenariuszach nie zaczynam od wyboru nowego CRM-u albo wymiany platformy sklepowej. Najpierw sprawdzam, gdzie powstaje ręczna praca.
Czy handlowiec zapisuje to samo w komentarzu i zadaniu? Czy pracownik codziennie dopasowuje produkty dostawców do kategorii? Czy w systemie są już informacje, ale nie ma funkcji wykonującej następny krok?
Czasem wystarczy zwykła reguła. Czasem dodatkowa funkcja w obecnym programie. W innym przypadku sens ma aplikacja połączona z CRM-em lub sklepem, która wykorzystuje AI tylko tam, gdzie potrzebna jest interpretacja.
Tak samo patrzę na przekazywanie zamówień handlowców do ERP bez przepisywania: zaczynam od przepływu informacji i zbędnych czynności, a dopiero później dobieram technologię.
Nie jest to pierwsza możliwość automatycznej klasyfikacji. Nowy kierunek polega na połączeniu szybkiej odpowiedzi, niskiego kosztu i interfejsu nastawionego na decyzje — dzięki temu warto ponownie przyjrzeć się procesom, które wcześniej odkładano jako zbyt kłopotliwe do automatyzacji. [2][3][6]
W ProcesON rozwijam aplikacje dopasowane do procesów firmy. Opisz używany system, czynność wykonywaną ręcznie i przybliżoną liczbę takich spraw. To podstawa rozmowy o zakresie oraz wycenie rozwiązania, które można dobudować do obecnego sposobu pracy.
Którą czynność chcesz usprawnić?
Opisz używany system i pracę, którą wykonujesz ręcznie. Sprawdzę, jakie rozwiązanie pasuje do Twojego procesu.
Założenia wyliczeń i źródła
Ceny i dokumentację sprawdzono 27 września 2026 r. Kwoty są symulacjami, przykłady pokazują oczekiwane działanie, a czasy odpowiedzi pochodzą od producenta. Nie wykonano porównawczych wywołań Jev i Luny.
Dla komentarza przyjęto 1000 tokenów wejściowych w obu modelach oraz 50 tokenów odpowiedzi Luny; dla produktu 2000 tokenów wejściowych i 100 tokenów odpowiedzi Luny. Wejście obejmuje instrukcje, opcje i kontekst, nie tylko widoczny tekst. To założone rozmiary, nie pomiar tych przykładów. Tokenizacja może się różnić między modelami.
Stawki za milion tokenów: Jev 0,042 USD za wejście, bez opłaty za wyjście; GPT-6 Luna Standard 0,10 USD za wejście i 0,50 USD za wyjście. Luna bez dodatkowego rozumowania i bez narzędzi, jedno wywołanie na element, bez cache. Batch: połowa stawek Standard. Kurs 1 USD = 4 zł jest umowny. Nie uwzględniono podatków, powtórzeń, dopłat, innych modeli, wdrożenia ani utrzymania. [6][7][8]
Oficjalne źródła
- TypeSafe — wprowadzenie i rodzaje pytań ↩
- TypeSafe — czym są modele System One ↩
- TypeSafe — architektura Jev, deklarowane czasy odpowiedzi i metodologia pomiarów ↩
- TypeSafe — równoległe ocenianie wielu pytań ↩
- TypeSafe — modele decyzyjne wewnątrz zwykłych aplikacji ↩
- TypeSafe — cennik, limity i obsługa języków ↩
- OpenAI — GPT-6 Luna: cennik i możliwości ↩
- OpenAI — Batch API ↩
- TypeSafe — ograniczenia Jev 1.13 ↩
- TypeSafe — wybór opcji ze zdefiniowanego zbioru ↩
- PrestaShop — produkt oraz powiązania z kategoriami, tagami i cechami ↩
- PrestaShop — zarządzanie produktem i cechami przez Webservice API ↩
- PrestaShop — atrybuty produktu ↩
- TypeSafe — pewność i prawdopodobieństwa ↩
- TypeSafe — kierowanie niejednoznacznych przypadków do sprawdzenia ↩